Je konec měsíce a vedení chce vědět, kolik firma utržila v jednotlivých krajích. Report se spustí, běží několik desítek minut a kolegové z obchodu si mezitím stěžují, že se jim informační systém „seká“. Pokud vám ta scéna připadá povědomá, nejste sami. A nejde o selhání vašeho IT. Je to problém starý přes padesát let a jeho řešení má jméno: sloupcové databáze.
V článku vysvětlíme, proč vůbec vznikly, jak fungují (bez nutnosti znát SQL) a hlavně kdy dávají smysl a kdy jsou zbytečné.
Obsah článku
Dvě otázky, které databáze slyší
Většina dotazů na firemní data patří do jedné ze dvou skupin. Ukážeme si je na tabulce objednávek, kde má každá objednávka své číslo, datum, zákazníka, produkt, kraj, počet kusů a částku.
První typ zní: „Najdi objednávku č. 1004 a změň u ní adresu doručení.“ Databáze potřebuje jeden konkrétní záznam, ale celý. A musí ho rychle a bezpečně změnit, i když totéž ve stejnou chvíli dělají stovky dalších uživatelů. Takhle pracuje e-shop, bankovní systém, ERP nebo agendový systém úřadu. Odborně se tomu říká transakční zpracování (OLTP).
Druhý typ zní: „Kolik jsme utržili po měsících za poslední tři roky?“ Tady je to přesně naopak. Databáze nepotřebuje žádný záznam celý, ale z milionů záznamů potřebuje dva údaje: datum a částku. Nic přitom nezapisuje, jen čte a počítá. Takhle pracuje reporting, BI nástroje, dashboardy a analytici. Tomu se říká analytické zpracování (OLAP).
Klasické relační databáze, tedy Oracle, SQL Server, PostgreSQL nebo MySQL v základní podobě, byly postavené na první typ otázek. Sloupcové databáze vznikly kvůli tomu druhému.
Princip v jedné minutě: kartotéka, nebo šuplíky?
Představte si lékařskou kartotéku. Každý pacient má svou kartu a na ní všechno: jméno, adresu, data návštěv, krevní tlak. Když přijde konkrétní pacient, sestra vytáhne jednu kartu a má vše po ruce. Přesně takhle ukládá data řádková databáze: všechny údaje jednoho záznamu leží fyzicky vedle sebe.
Teď si představte, že vedení nemocnice chce znát průměrný krevní tlak všech pacientů za loňský rok. Sestra musí vytáhnout každou kartu, najít na ní tlak a kartu zase zastrčit. Jméno, adresa ani diagnóza ji nezajímají, ale v ruce je mít musí.
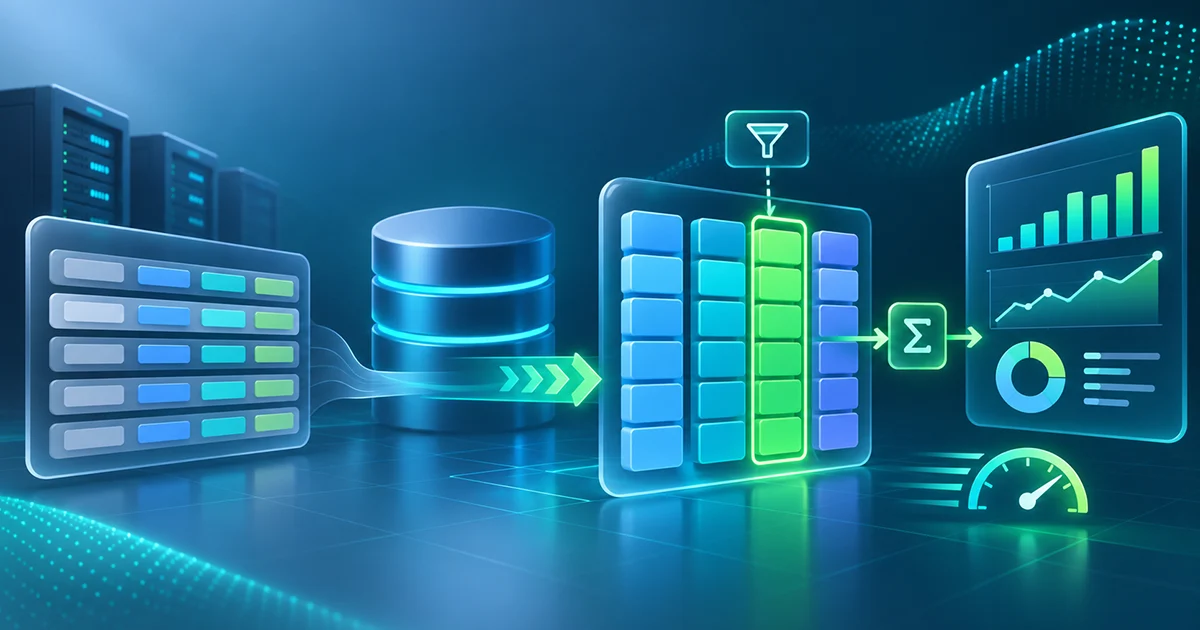
Sloupcová databáze to dělá jinak. Místo karet má šuplíky: v jednom jsou všechna jména, ve druhém všechna data návštěv, ve třetím všechny krevní tlaky. Na průměrný tlak stačí otevřít jediný šuplík. Na kartu konkrétního pacienta je naopak potřeba sáhnout do všech šuplíků a údaje poskládat.
Navenek přitom obě databáze vypadají stejně: tabulky, řádky, sloupce a stejný jazyk SQL. Rozdíl je jen v tom, jak data leží „pod kapotou“. Vyzkoušejte si to sami:
- Přečteno dat100 %z celé tabulky
- Přečteno hodnot8 000 000z 8 000 000 (8 sloupců × 1 000 000 řádků)
- Míst, kam musí sáhnout1souvislé čtení celé tabulky
Proč vznikly: 50 let hledání odpovědi na druhou otázku
Sloupcové databáze nejsou novinka posledních let. Myšlenka je stará přes půl století, jen dlouho čekala na svou chvíli. Jejich příběh se nejlépe vypráví jako řetěz potřeb a výsledků: pokaždé se objevil nový problém a s ním nové řešení.
70. léta: svět transakcí
Potřeba: Banky, aerolinky a obchodní firmy chtěly počítačově zpracovávat převody, rezervace a objednávky. Spolehlivě, souběžně a bez ztráty jediného záznamu.
Výsledek: V roce 1970 publikoval Edgar F. Codd z IBM relační model dat, tedy myšlenku ukládat data do tabulek. IBM pak v projektu System R vyvinulo jazyk SQL a v roce 1979 uvedla firma, ze které se později stal Oracle, první komerčně dostupnou SQL databázi. Tyto systémy byly navržené pro první typ otázek, a proto ukládaly všechny údaje jednoho záznamu vedle sebe. Dávalo to smysl tehdy a v provozních systémech to smysl dává dodnes.
Pro náš příběh je důležitý jeden Coddův požadavek: uživatelé mají být „chráněni před nutností vědět, jak jsou data v počítači uspořádána“. Díky tomuto oddělení může dnes sloupcová databáze vypadat navenek úplně stejně jako řádková a uvnitř přitom fungovat zcela jinak.
Mezitím u statistiků: data, která se nezapisují, ale sčítají
Potřeba: Ne všichni ale řešili transakce. Statistické úřady a vědci měli opačný problém: obrovské tabulky s mnoha údaji, které se jednou nahrají a pak se nad nimi už jen počítají souhrny.
Výsledek: První systém, který ukládal data po sloupcích, vznikl už v roce 1969. Jmenoval se TAXIR a sloužil k vyhledávání v biologických datech. V roce 1976 pak kanadský statistický úřad Statistics Canada nasadil systém RAPID pro zpracování sčítání lidu a bytů. Sdílel ho s dalšími statistickými úřady ve světě a provozoval ho až do 90. let. Jedna z prvních sloupcových databází tedy vznikla ve státní správě, a to z úplně praktického důvodu: sčítání lidu je učebnicový příklad druhé otázky.
Dobrý nápad ve špatné době (1985–2000)
Potřeba: Pokud sloupce fungovaly, proč se neprosadily všude? Odborníci chtěli vědět, které uspořádání dat je obecně lepší.
Výsledek: V roce 1985 publikovali George Copeland a Setrag Khoshafian systematické srovnání obou přístupů. Jejich závěr byl střízlivý: ani jedno uspořádání není jednoznačně lepší, rozhoduje typ práce. Sloupcové ukládání tehdy zrychlilo jen dotazy na několik málo sloupců a zabralo víc místa na disku.
Rozhodoval hardware. Typický počítač kolem roku 1980, VAX 11/780, měl procesor s výkonem zhruba milion instrukcí za sekundu, nejvýš 8 MB paměti a disk s kapacitou 80 MB, který přenášel 1,2 MB za sekundu. Stál 250 000 dolarů. Procesor a disk byly zhruba v rovnováze, takže to, že databáze čte i nepotřebné údaje, nebyl hlavní problém.
Komerční sloupcové produkty se objevily v 90. letech. Jedním z prvních byl Sybase IQ, který v polovině 90. let ukázal přínos komprimovaných sloupců v analytice. Podle pozdější přehledové monografie (Abadi a kol., 2013) ale přišel na trh příliš brzy a velkou pozornost nezískal. Svou cestou šly i finance, kde se sloupcová databáze kdb+ stala standardem pro analýzu záznamů o každém obchodu na burze.
Nůžky se rozevřely (1980–2005)
Potřeba: Během dalších 25 let se poměr sil uvnitř počítače zásadně změnil. Firmy navíc začaly sbírat data v objemech, o jakých se dřív nikomu nesnilo, a datové sklady rostly do terabajtů.
Podle Abadiho a kol. byly procesory kolem roku 2010 5 000–10 000× rychlejší než v roce 1980. Rychlost čtení z disku se ale zlepšila jen zhruba 100× a doba vyhledání místa na disku asi 10×. Procesor tak většinu času čekal, až mu disk a paměť data dodají. Úzkým hrdlem přestal být výpočet a stalo se jím „dostat data k procesoru“. A přesně to sloupcové databáze řeší: čtou méně dat.
-
Výkon procesoru5 000–10 000× rychlejšíaž 10 000×
-
Rychlost čtení z diskuzhruba 100× rychlejší100×
-
Vyhledání místa na diskuzhruba 10× rychlejší10×
Výsledek: Rok 2005 je symbolický zlom. Michael Stonebraker, jeden z nejvýznamnějších databázových výzkumníků a pozdější nositel Turingovy ceny, publikoval se spoluautorem článek s výmluvným názvem „One Size Fits All“: An Idea Whose Time Has Come and Gone. Tvrdil v něm, že éra jedné univerzální databáze na všechno končí a trh se rozpadne na specializované systémy. Ve stejném roce představil se spoluautory sloupcovou databázi C-Store, ze které vznikl komerční produkt Vertica. Na vlastním testu byl jejich prototyp v průměru 164× rychlejší než tehdejší komerční řádková databáze. Měřili to autoři na vlastním prototypu, takže číslo berte spíš jako ukázku potenciálu než jako slib.
Také v roce 2005 přišel amsterdamský výzkumný ústav CWI s projektem MonetDB/X100, který přinesl takzvané vektorizované zpracování (vysvětlíme níže). Z něj vznikl produkt VectorWise a jeden z autorů, Marcin Żukowski, později spoluzaložil Snowflake. Na konci desetiletí následovala vlna sloupcových produktů a velcí dodavatelé začali sloupcové funkce přidávat i do svých databází.
Web a cloud (2010–2015)
Potřeba: Internetové firmy začaly pracovat s petabajty dat. A firmy obecně nechtěly kupovat drahý hardware, který většinu času čeká na měsíční report.
Výsledek: Google v roce 2010 popsal systém Dremel pro interaktivní dotazy nad obrovskými sloupcovými daty, na kterém stojí služba BigQuery. Amazon v listopadu 2012 ohlásil cloudový datový sklad Redshift. Při uvedení ho prezentoval tak, že místo 19 000–25 000 dolarů za terabajt ročně u vlastního datového skladu bude stát méně než 1 000 dolarů za terabajt ročně (šlo o výpočet a marketingové srovnání Amazonu). Ve stejném roce vznikl Snowflake s myšlenkou oddělit úložiště od výpočtu: data leží levně v cloudu a výkon se zapíná, jen když běží dotaz. A v roce 2013 vznikl otevřený sloupcový formát souborů Apache Parquet. Twitter tehdy uvedl, že mu zmenšil velké datové sady o třetinu. Dnes je Parquet de facto standardem pro ukládání analytických dat.
Reporty v reálném čase (2009–2016)
Potřeba: Ruský Yandex provozoval webovou analytiku Yandex.Metrica, obdobu Google Analytics. Chtěl vědět, jestli se dá vytvořit report v reálném čase přímo z neagregovaných dat, která navíc pořád přibývají. Bez nočních přepočtů a předpočítaných souhrnů.
Výsledek: Alexej Milovidov proto začal psát vlastní sloupcovou databázi. Prototyp vznikl v roce 2009, první produkční nasazení přišlo v roce 2012 (Metrica na ni plně přešla v roce 2014) a v červnu 2016 byla uvolněna jako open source pod názvem ClickHouse. Rychle se rozšířila i mimo Yandex: Cloudflare na ní v roce 2018 popsal analytiku nad průměrně 6 miliony HTTP požadavků za sekundu. Sloupcová databáze tak přestala být jen nástrojem pro noční reporty a stala se i nástrojem pro dashboardy a monitoring v reálném čase. Dnes ji vyvíjí americká firma ClickHouse, Inc., která se v roce 2021 vyčlenila z Yandexu a sídlí v Kalifornii.
Dnes: sloupce jsou všude
Sloupcové ukládání se stalo samozřejmostí. Kromě cloudových skladů (Snowflake, BigQuery, Redshift, Databricks) a specializovaných databází (ClickHouse, Vertica) existuje například DuckDB, který běží přímo na notebooku bez serveru. Tradiční dodavatelé mají sloupcové funkce přímo ve svých databázích: Oracle Database In-Memory, columnstore indexy v SQL Serveru, SAP HANA nebo IBM Db2 BLU. A datová jezera ukládají data v Parquetu, nad kterým běží formáty jako Apache Iceberg.
Celý příběh na jednom místě:
Proč je to tak rychlé: tři triky
To, že databáze čte jen potřebné sloupce, je jen začátek. Rychlost sloupcových databází stojí na třech tricích, jejichž účinek se násobí.
1. Čte se jen to, co je potřeba
Tabulky v datových skladech mívají desítky až stovky sloupců, ale běžný dotaz jich potřebuje několik. AWS to ve své dokumentaci ilustruje jednoduše: když má řádek 10 sloupců a vy počítáte s jedním, sloupcová databáze načte jen ten jeden. Méně přečtených dat znamená méně čekání na disk, i když celkové zrychlení bývá menší než samotný poměr sloupců.
2. Komprese: podobné hodnoty vedle sebe
Ve sloupci leží data stejného typu a často se opakují. Vezměte sloupec Kraj v tabulce milionu obyvatel. Obsahuje jen 14 různých hodnot, takže si databáze může názvy krajů nahradit čísly od 1 do 14 (slovníkové kódování). A když jsou data seřazená, nemusí ani opakovat stejné číslo. Stačí zapsat například „Jihomoravský × 113 000“ (takzvaný run-length encoding). V řádkové databázi se názvy krajů střídají se jmény, adresami a částkami, takže takhle zkomprimovat nejdou.
Microsoft u sloupcových indexů v SQL Serveru uvádí až desetinásobnou kompresi oproti nekomprimovaným datům. Menší data přitom neznamenají jen úsporu disku: z disku i paměti se přečte méně, takže se zrychlí i samotný dotaz.
3. Zpracování po dávkách
Klasická databáze zpracovává data po jednotlivých řádcích, podobně jako pokladní, která markuje zboží kus po kusu. Moderní sloupcové databáze zpracovávají hodnoty po větších dávkách, například tisíc částek v jednom kroku. Dávka se vejde do rychlé vyrovnávací paměti procesoru a moderní procesory navíc umějí jednou instrukcí zpracovat několik hodnot současně. Tomuto přístupu se říká vektorizované zpracování a v roce 2005 s ním přišel právě projekt MonetDB/X100.
Rychlost dává celá architektura, ne samotné sloupce
Pro férovost jedna důležitá poznámka. Abadi a kol. ve své monografii ukazují, že sloupcová databáze bez dalších optimalizací byla na testu dokonce mírně pomalejší než komerční řádková. Teprve s kompresí, dávkovým zpracováním a dalšími úpravami byla zhruba pětkrát rychlejší. Výhoda tedy nepramení jen z toho, že data leží ve sloupcích, ale z celé architektury, která je kolem toho postavená. Proto také čísla typu „100× rychlejší“ v marketingových materiálech berte s rezervou. Výsledek vždy záleží na vašich datech a dotazech.
Kde sloupcové databáze narážejí
Šuplíky mají i svou stinnou stránku. Je to přesně ta první otázka, kterou řádkové databáze zvládají nejlépe.
- Zápis a úprava jednotlivých záznamů. Nová objednávka v řádkové databázi znamená zapsat jeden řádek. Ve sloupcové se musí zapsat do každého sloupce zvlášť. Oracle to u svého sloupcového formátu popisuje přímo: kvůli vložení nebo smazání jediného záznamu je potřeba změnit všechny sloupcové struktury tabulky. U komprimovaných dat se navíc musí přepisovat celé bloky.
- Načtení celého záznamu. Na kartu konkrétního zákazníka musí databáze sáhnout do všech šuplíků. Rozdíl ale obvykle není dramatický: studie z roku 2006 (Harizopoulos a kol.) ukázala, že když dotaz čte všechny sloupce, výhoda sloupcového uložení zmizí a může vyjít i mírně pomalejší než řádkové.
- Mnoho malých souběžných transakcí. Stovky uživatelů, kteří zároveň zakládají a upravují záznamy, nejsou silnou stránkou většiny sloupcových systémů.
- Malá data. Komprese a dávkové zpracování se vyplatí až u velkých objemů. SQL Server například komprimuje data po skupinách až zhruba milionu řádků a menší dávky nových řádků drží nejdřív nekomprimované. U tabulky s desítkami tisíc řádků rozdíl nepoznáte.
Výrobci se s tím vyrovnávají podobně: nová data nejdřív zapíšou do malé zapisovatelné části a teprve na pozadí je po dávkách setřídí, zkomprimují a přesunou do sloupcového úložiště. Tak to dělal už C-Store v roce 2005 a podobně fungují i dnešní systémy, například SQL Server nebo ClickHouse se svými tabulkami MergeTree. Proto sloupcové databáze nejlépe zvládají data, která se nahrávají po větších dávkách a zpětně se mění jen výjimečně.
-
Sloupcová analytická databáze
- UkládáníHodnoty jednoho sloupce leží vedle sebe
- JazykSQL, relační tabulky
- Silná stránkaSoučty, průměry a reporty nad miliardami řádků
- PříkladyClickHouse, Vertica, Snowflake, BigQuery, Redshift, DuckDB
-
Wide-column NoSQL úložiště
- UkládáníPo řádcích uvnitř rodin sloupců, flexibilní schéma
- JazykVlastní API nebo jazyk podobný SQL
- Silná stránkaMasivní zápisy a rychlé čtení podle klíče
- PříkladyCassandra, HBase, ScyllaDB, Bigtable
Kdy sloupcová databáze dává smysl a kdy ne
Dobrá zpráva je, že rozhodnutí obvykle není složité. Stačí si poctivě odpovědět, jaké otázky svým datům kladete.
Sloupcová databáze dává smysl, když:
- děláte reporty, dashboardy nebo analýzy nad miliony až miliardami řádků,
- dotazy potřebují jen několik sloupců z mnoha,
- data hlavně přibývají a zpětně se mění jen výjimečně: logy, transakce, měření ze senzorů, události z webu nebo aplikací,
- reporting zpomaluje provozní systém nebo musí běžet přes noc,
- chcete pracovat s celou historií dat, ne jen s předpočítanými souhrny,
- potřebujete dashboardy nebo monitoring nad čerstvými daty v reálném čase.
Sloupcová databáze smysl nedává, když:
- jde o jádro aplikace, kde se neustále zakládají a upravují jednotlivé záznamy (e-shop, ERP, CRM, agendový systém),
- pracujete hlavně s celými záznamy, třeba s detailem zákazníka, objednávky nebo spisu,
- máte malá data: desítky či stovky tisíc řádků zvládne běžná databáze bez potíží,
- report potřebujete jednou za měsíc a jeho rychlost nikoho netrápí.
Pro rychlou orientaci si můžete projít šest otázek:
Obojí, ne buď–anebo
Nejčastější omyl je chápat sloupcové databáze jako náhradu těch řádkových. Ve skutečnosti je většina středních a velkých firem i úřadů provozuje vedle sebe. Provozní systémy dál běží na řádkové databázi, protože potřebují rychlé a bezpečné transakce. Data se z nich průběžně kopírují do analytické databáze, kde nad nimi běží reporty a dashboardy. Provoz tak není zatížený analytikou a analytika nečeká na provoz.
- Provozní systémy ERP, e-shop, CRM, agendový systém. Běží na řádkové (transakční) databázi. „Najdi a změň tento záznam.“
- Přenos dat ETL nebo průběžná replikace změn (CDC), po dávkách i v reálném čase.
- Analytická databáze Sloupcové úložiště: datový sklad, lakehouse nebo specializovaná analytická databáze. „Kolik, kolikrát a jak se to vyvíjí?“
- Reporty a dashboardy Power BI, Grafana, Superset, analytici a datoví vědci.
Pokud o sloupcové databázi uvažujete, osvědčuje se postupovat zhruba takto:
- Provozní systémy nechte, kde jsou. Transakční databáze dělá svou práci dobře.
- Zjistěte, co už máte. Pokud provozujete Oracle, SQL Server nebo SAP HANA, vyzkoušejte nejdřív jejich vestavěné sloupcové funkce. U menších objemů mohou stačit.
- Analytiku přesuňte do sloupcového úložiště, jakmile data rostou a reporty začínají brzdit provoz.
- Pro specifické úlohy zvolte specializovaný nástroj. Pro velké a rychle rostoucí objemy cloudový datový sklad, pro logy, telemetrii a dashboardy v reálném čase specializovanou analytickou databázi.
Stonebrakerova předpověď z roku 2005 se tak naplnila, jen trochu jinak, než by se dalo čekat. Jedna databáze na všechno opravdu skončila, ty staré ale nezmizely. Každá dnes dělá to, co umí nejlépe.
Závěr
Sloupcové databáze nevznikly jako módní vlna, ale jako odpověď na velmi starou otázku: jak rychle spočítat souhrn z obrovského množství dat. Myšlenka existovala od 70. let, prosadila se ale až ve chvíli, kdy dat výrazně přibylo a procesory začaly čekat na disky. Dnes je sloupcové ukládání standardem všude, kde se data analyzují, od cloudových skladů až po databáze, které běží na notebooku.
Pro vaše rozhodování platí jednoduché pravidlo. Pokud se ptáte „najdi a změň tento záznam“, zůstaňte u řádkové databáze. Pokud se nad miliony záznamů ptáte „kolik, kolikrát a jak se to vyvíjí“, sloupcová databáze vám pravděpodobně ušetří čas, peníze i nervy.
Jednou z databází, které vyrostly přímo z potřeby analytiky v reálném čase, je open-source ClickHouse. V Solutii ho navrhujeme, nasazujeme a spravujeme na vlastních serverech zákazníků i v cloudu.
-
Na vlastních serverech i v clouduNa vlastním hardwaru, ve spravované službě ClickHouse Cloud nebo ve vašem cloudovém účtu (BYOC).
-
Bez licenčních poplatků za databáziOpen source pod licencí Apache 2.0, bez vazby na jednoho dodavatele.
-
Ověření na vašich datechNež se rozhodnete, uvidíte výsledky na vlastních dotazech a reportech.
Zdroje
- The Design and Implementation of Modern Column-Oriented Database Systems, D. Abadi, P. Boncz, S. Harizopoulos, S. Idreos, S. Madden, Foundations and Trends in Databases, 2013 (historie, hardware 1980 vs. 2010, Sybase IQ, MonetDB, C-Store, test optimalizací)
- A Relational Model of Data for Large Shared Data Banks, E. F. Codd, Communications of the ACM, červen 1970
- History of SQL, Oracle, dokumentace (SEQUEL/SQL v IBM, Oracle 1979)
- Column Oriented Databases, IRAJ, přehledový článek (TAXIR 1969, RAPID 1976, sekundární zdroj)
- A DBMS for Large Statistical Databases, Turner a kol., VLDB 1979 (databázový systém Statistics Canada)
- A Decomposition Storage Model, G. Copeland, S. Khoshafian, ACM SIGMOD 1985
- kdb+, Wikipedia (sloupcová databáze pro finanční časové řady)
- „One Size Fits All“: An Idea Whose Time Has Come and Gone, M. Stonebraker, U. Çetintemel, ICDE 2005
- ACM Turing Award Goes to Pioneer in Database Systems Architecture, ACM, 25. 3. 2015
- C-Store: A Column-oriented DBMS, M. Stonebraker a kol., VLDB 2005 (výsledky měřili autoři na vlastním prototypu)
- Teaching an Old Elephant New Tricks, N. Bruno, CIDR 2009 (shrnutí výsledku C-Store 164×)
- MonetDB/X100: Hyper-Pipelining Query Execution, P. Boncz, M. Żukowski, N. Nes, CIDR 2005
- Test of Time Award for paper on vectorized execution, CWI (VectorWise, Żukowski a Snowflake)
- Dremel: A Decade of Interactive SQL Analysis at Web Scale, S. Melnik a kol., VLDB 2020 (Dremel 2010 a BigQuery)
- Amazon Web Services Announces Redshift, New Data Warehouse Service, TechCrunch, 28. 11. 2012
- Amazon Debuts Low-Cost, Big Data Warehousing, InformationWeek, listopad 2012 (výpočet nákladů Amazonu, materiál dodavatele)
- The Snowflake Elastic Data Warehouse, B. Dageville a kol., ACM SIGMOD 2016 (oddělení úložiště a výpočtu)
- Snowflake Inc., Wikipedia (založení v roce 2012)
- Dremel made simple with Parquet, Twitter Engineering, 11. 9. 2013
- ClickHouse: History, A. Milovidov, prezentace, 2. 10. 2021 (prototyp 2009, produkce 2012, Metrica 2014)
- Ten years of ClickHouse in open source, ClickHouse blog, 15. 6. 2026
- Yandex Spins Off ClickHouse into Standalone Company, Yandex, 20. 9. 2021
- We stand with Ukraine, ClickHouse blog, 2022 (sídlo ClickHouse, Inc. v USA)
- HTTP Analytics for 6M requests per second using ClickHouse, Cloudflare blog, 6. 3. 2018
- MergeTree, ClickHouse, dokumentace
- DuckDB: An Embeddable Analytical Database, M. Raasveldt, H. Mühleisen, ACM SIGMOD 2019
- What is a Columnar Database?, AWS (čtení jednoho sloupce z deseti, rozdíl oproti wide-column)
- Columnstore indexes: Overview, Microsoft Learn (komprese až 10× oproti nekomprimovaným datům, deltastore, materiál dodavatele)
- Oracle Database In-Memory with Oracle Database 19c, Oracle, technical white paper (zápis do řádkového a sloupcového formátu)
- Performance Tradeoffs in Read-Optimized Databases, S. Harizopoulos, V. Liang, D. Abadi, S. Madden, VLDB 2006
- Distinguishing Two Major Types of Column-Stores, D. Abadi, DBMS Musings, březen 2010
- Počty obyvatel v jednotlivých krajích Česka, ČTK podle dat ČSÚ, stav k 30. 6. 2023 (rozložení obyvatel v ukázce komprese)
Fakta odpovídají stavu k 20. 11. 2026. Čísla dodavatelů (Microsoft, Amazon) a výsledky testů, které měřili sami autoři (C-Store, MonetDB/X100), jsou v textu označena jako jejich tvrzení. Výpočet v ukázce komprese je ilustrační.
Při tvorbě článku bylo využito generativní AI.